KI-Rechenzentren: Sechs bedeutende Ankündigungen von Intel, AMD und Nvidia
Auf der bis heute laufenden Messe OCP im Silicon Valley kündigte Intel Details an zu seiner neuen Rechenzentrums-GPU sowie zu Server-Racks mit Intel-Xeon-CPUs mit insgesamt mehr als 46.000 Kernen. AMD stellte sein neues flexibles Referenzdesign für Server-Racks und Open-Source-Lösungen vor. Neuigkeiten zu Vera-Rubin-Racks gab es von Nvidia.
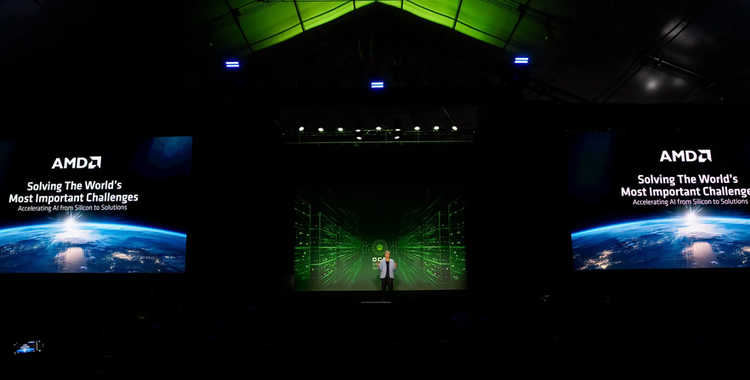
Das Interesse an der Zukunft der Rechenzentrumsinfrastruktur ist so groß, dass der Veranstalter des diesjährigen OCP Global Summit in San Jose erklärte, die "maximale Kapazität" sei erreicht. Nicht registrierten Personen werde der Zutritt verweigert – auch wenn sie ihre Reise bereits gebucht hätten. Die jährlich stattfindende Leitmesse (12. bis 15. Oktober 2026) schließt am heutigen Donnerstag.
Berichten zufolge nahmen rekordverdächtige 15.000 Menschen an der Veranstaltung des von Meta gegründeten Open Compute Project teil. Die großen Halbleiterhersteller Intel, AMD und Nvidia zeigen dort, wie sie künftige KI-Rechenzentren mit neuen Technologien antreiben wollen. Viele davon basieren auf standardisierten Serverspezifikationen, für die sich das OCP einsetzt.
Zu den Ankündigungen gehörten neue Details zu Intels kommender luftgekühlter Rechenzentrums-GPU, neue Server-Racks mit Intel-Xeon-CPUs und insgesamt mehr als 46.000 Kernen, ein neues flexibles Referenzdesign für Server-Racks von AMD, die erste AMD-EPYC-CPU mit LPDDR-Speicherschnittstelle sowie Open-Source- und Vera-Rubin-Neuigkeiten von Nvidia.
Kontrolle der Tokenkosten ganz oben auf der Kundenagenda
Einige dieser Ankündigungen richteten sich an Partner und Kunden, die Rechenzentren für agentenbasierte KI-Workloads bauen. Das gilt insbesondere für die CPU-Neuigkeiten, da dieser Prozessortyp für solche Anwendungen immer wichtiger wird. Andere Ankündigungen sollen den breiteren Ausbau von KI-Rechenzentren unterstützen.
Nvidia liegt beim Umsatz im Markt für KI-Infrastruktur zwar deutlich vor Intel und AMD. Laut Bob Venero, CEO des Lösungsanbieters Future Tech Enterprise aus Fort Lauderdale/Florida werden jedoch alle drei Unternehmen benötigt, damit Channel-Partner den anhaltenden Ausbau von KI-Rechenzentren bewältigen können. "Der Channel braucht AMD, Intel und Nvidia, damit sie die Grenzen weiter verschieben", sagte er.
Hyperscaler und Neocloud-Anbieter bauen derzeit einen großen Teil der Rechenzentrumskapazitäten für agentenbasierte KI auf. Manager Venero sieht dennoch eine große Chance für den Channel, Unternehmen dabei zu helfen, wegen Sicherheits- und Kostenbedenken eine eigene Infrastruktur aufzubauen. "Die Kunden erkennen das auf jeden Fall, weil sie sehr viel Geld ausgegeben und ihre Token-Budgets überschritten haben, nachdem sie KI-Agenten in ihren Unternehmen unreguliert laufen ließen", sagte er. "Deshalb fragen sich Kunden jetzt verstärkt: Wie kontrollieren wir die Kosten? Wie betreiben wir diese Agenten intern, sodass sie unsere internen Modelle nutzen und Aufgaben nicht zwingend cloudbasiert, sondern On-Premises ausführen?"
Im Folgenden finden Sie die wichtigsten Details zu diesen sechs großen Ankündigungen auf dem OCP 2026.
Intel nennt Details zur 480-GB-GPU der D-Serie für luftgekühlte Server
Intel gab bekannt, dass seine kommende 480-GB-Rechenzentrums-GPU "Crescent Island" für KI-Inferenz unter der Bezeichnung Intel GPU D-Serie erscheinen wird. Sie soll bei einer Leistungsaufnahme von 350 Watt bis zu 1,3 Petaflops Rechenleistung mit 8-Bit-Gleitkommazahlen bieten.
Laut dem Chiphersteller wird die GPU der D-Serie, die derzeit von Kunden getestet wird, im standardisierten, luftgekühlten PCIe-Formfaktor angeboten. Dadurch lässt sie sich einfach in bestehende Rechenzentren integrieren; pro Server sind bis zu acht PCIe-Karten möglich.
Intel arbeitet nach eigenen Angaben mit einem "breiten Ökosystem" aus OEMs, ODMs, Neocloud-Anbietern, ISVs, Appliance-Anbietern und KI-nativen Unternehmen zusammen, um die GPU der D-Serie in die Serienproduktion zu bringen. Dazu zählen Asus, Cisco, Dell Technologies, HPE, Lenovo, Supermicro, NetApp, Nutanix, Red Hat von IBM und VMware by Broadcom.
Intel: GPU der D-Serie soll erfolgreicher werden als Gaudi-Chipreihe
Die GPU der D-Serie ist Intels jüngster Versuch, im Markt für KI-Beschleuniger Fuß zu fassen, nachdem frühere Vorstöße, darunter die Gaudi-Chipreihe, keine breite Akzeptanz fanden. Das neue Produkt nutzt die Xe3P-Architektur, die aus der Xe-Architektur hervorgegangen ist, die Intel vor mehreren Jahren für Client- und Server-GPUs zu entwickeln begann.
Nach Angaben des Halbleiterkonzerns ist die GPU der D-Serie für große Sprachmodelle, Workloads mit langen Kontextfenstern und parallel betriebene Dienste ausgelegt. Eine einzelne Karte unterstützt Modelle mit bis zu 300 Milliarden Parametern, ein System mit acht GPUs Modelle mit bis zu einer Billion Parametern.
Die neue Produktlinie soll direkt mit Nvidias RTX Pro 6000 Blackwell Server Edition konkurrieren. Diese GPU bietet 2 Petaflops Rechenleistung mit 8-Bit-Gleitkommazahlen (FP8), 4 Petaflops mit 4-Bit-Gleitkommazahlen (FP4) und 96 GB GDDR7-Speicher in einem PCIe-Formfaktor, der auf bis zu 600 Watt Leistungsaufnahme konfiguriert werden kann.
Nvidia nennt auf seiner Website zwar keine Leistungsunterschiede zwischen den luft- und flüssigkeitsgekühlten Versionen der RTX Pro 6000. Ein direkter Vergleich der veröffentlichten technischen Daten mit Intels GPU der D-Serie sieht die Nvidia-Karte jedoch bei der FP8-Leistung vorn. Zudem unterstützt sie FP4, wodurch Anwendungen schneller ausgeführt werden können.
Die GPU der D-Serie von Intel bietet dagegen mit 480 GB deutlich mehr Speicher und trotz LPDDR5X mit 1,5 TB/s eine ungefähr vergleichbare Speicherbandbreite. Zudem scheint sie energieeffizienter zu sein, da sie 1,3 Petaflops FP8-Rechenleistung bei nur 350 Watt erreicht.
Intel zufolge entspricht die GPU der D-Serie der Strategie des Unternehmens, offene System- und Softwarearchitekturen anzubieten, mit denen Entwickler Workloads einfach auf der jeweils passenden Hardware bereitstellen können.
Neue Intel-Xeon-Server-Racks bieten 46.000 CPU-Kerne für agentenbasierte KI
Intel präsentierte neue Server-Rack-Designs, die mehr als 46.000 Kerne der Xeon-6+-CPUs des Unternehmens für agentenbasierte KI-Workloads aufnehmen können. Die Rack-Designs stammen von Serverherstellern wie Asus, Gigabyte und Supermicro. Viele basieren auf dem Open-Rack-v3-Standard des Open Compute Project, um laut Intel "Bereitstellung und Integration in offene Rechenzentrumsinfrastrukturen zu vereinfachen".
Der Halbleiterkonzern zeigte die Systeme vor dem Hintergrund einer stark steigenden CPU-Nachfrage infolge des rasanten Wachstums agentenbasierter KI-Workloads in Rechenzentren.
Die auf dem OCP Global Summit vorgestellten Server-Racks sind mit einer hohen CPU-Dichte ausgelegt, um "Workloads zu orchestrieren, Daten zu verarbeiten, Ein- und Ausgaben zu verwalten und Aufgaben auszuführen, die Beschleunigerchips wie GPUs mit voller Geschwindigkeit betreiben," so der Chiphersteller.
In einigen Konfigurationen können diese Server-Racks laut Intel mehr als 46.000 Kerne der Xeon-6+-Prozessoren bei einer Rack-Leistungsaufnahme von 133,45 Kilowatt aufnehmen.
Die im Sommer eingeführten Xeon-6+-Prozessoren mit dem Codenamen "Clearwater Forest" bieten bis zu 288 Effizienzkerne bei einer Leistungsaufnahme von 450 Watt.
AMD stellt flexibles "Helion"-Server-Rack-Design für agentenbasierte KI vor
AMD stellte ein flexibles Referenzdesign für Server-Racks namens "Helion" vor. Damit können Partner die Rechenanforderungen für Kunden mit agentenbasierten KI-Workloads individuell anpassen.
AMD bezeichnet Helion als "offenen Bauplan". Das Design basiert auf einer Spezifikation des Open Compute Project und kann EPYC-CPUs und Instinct-GPUs oder ausschließlich CPUs einsetzen. Nach Angaben von AMD wollen Serverhersteller ab November Helion-Rack-Konfigurationen auf den Markt bringen. Unterstützt wird das Design unter anderem von Cisco, Dell Technologies, HPE, Lenovo und Supermicro.
Damit unternimmt AMD einen weiteren Schritt, um Nvidias Dominanz im Markt für KI-Infrastruktur herauszufordern und den Druck auf Wettbewerber wie Intel aufrechtzuerhalten. Zugleich sorgen agentenbasierte KI-Workloads für eine beispiellose CPU-Nachfrage.
Helion soll Kunden ermöglichen, "CPU-Leistung, Kerndichte und Stromverbrauch mit der GPU-Beschleunigung für die Aufgaben ihrer KI-Agenten abzustimmen", erklärte AMD.
Kunden können damit "praktisch jede Konfiguration" erstellen, die ihren Workload-Anforderungen entspricht. Dazu gehören sowohl flüssigkeits- als auch luftgekühlte Helion-Versionen.
Ein reines CPU-Rack mit EPYC-Prozessoren der sechsten Generation kann laut AMD beispielsweise bis zu 32.768 Kerne für Hyperscaler bereitstellen, die "dedizierte Kapazitäten für die Ausführung von Agenten und Verbindungen zu einer separaten Infrastruktur für Modellinferenz" benötigen.
Helion ermöglicht nach Angaben des Unternehmens außerdem ein All-in-One-Rack, das "AMD-EPYC-CPU-Knoten, AMD-Instinct-MI350P-GPU-Knoten und universelle Rechenressourcen auf einer Plattform" für Unternehmenskunden mit agentenbasierten KI-Workloads vereint.
AMD stellt EPYC-"Verano"-CPU mit 192 Kernen und LPDDR-Speicher vor
AMD-CEO Lisa Su stellte eine neue EPYC-CPU mit bis zu 192 Kernen vor, die erstmals in dieser Prozessorfamilie über eine LPDDR-Speicherschnittstelle verfügt. Die CPU mit dem Codenamen "Verano" gehört zur sechsten EPYC-Generation "Venice" von AMD. Sie sei auf einen möglichst niedrigen Systemstromverbrauch optimiert und verfüge über eine aktualisierte CPU-zu-GPU-Bandbreite, wodurch sie sich "außergewöhnlich gut" als Host-Knoten in GPU-Servern eigne, sagte Su. Verano soll laut Su in der ersten Hälfte des Jahres 2027 in Produktion gehen.
Die CPU erweitert AMDs Angebot innerhalb der im Sommer eingeführten sechsten EPYC-Generation. Dazu gehören Varianten für Technical Computing und High Performance Computing sowie für Workloads, die hohe Kernzahlen bei niedrigem Stromverbrauch und hohen Taktfrequenzen erfordern.
Nvidia stellt Run:ai und weitere KI-Rechenzentrumssoftware als Open Source bereit
Nvidia hat Softwarekomponenten für verschiedene Bereiche des Betriebs von KI-Rechenzentren veröffentlicht, darunter Run:ai, unter Open-Source-Lizenzen. Der Anbieter veröffentlicht diese Softwarekomponenten im Rahmen seiner Plattform DSX AI Factory. Sie bündelt Softwarebibliotheken, Workflow-Leitfäden und Referenzdesigns, damit Partner und Kunden in KI-Rechenzentren möglichst viele Token pro Watt erzielen können.
Die Initiative ist Teil von Nvidias Strategie, eine "vertikal integrierte" und zugleich "horizontal offene" Plattform bereitzustellen – eine Formulierung, die das Unternehmen in diesem Jahr häufig verwendet.
Der bemerkenswerteste Schritt betrifft Run:ai, eine Kubernetes-basierte Software für Workload-Management und -Orchestrierung, die Nvidia Ende 2024 Berichten zufolge für 700 Mio. US-Dollar übernommen hatte.
Bei der Ankündigung der Übernahme Anfang desselben Jahres erklärte Nvidia, Run:ai solle DGX Cloud stärken. Der 2023 gestartete kommerzielle Full-Stack-Dienst sollte das KI-Training in öffentlichen Cloud-Umgebungen vereinfachen. Ende 2025 änderte das Unternehmen jedoch seinen Kurs. Berichten zufolge strukturierte Nvidia das DGX-Cloud-Geschäft um und verlagerte den Fokus auf eine "interne Cloud-Umgebung für Entwicklung und Betrieb von KI", wie es inzwischen auf Nvidias DGX-Cloud-Seite heißt.
Mit der Open-Source-Freigabe sei es nun "jedem Partner im Nvidia-DSX-Ökosystem und jeder KI-Cloud möglich, den Workload-Durchsatz zu erhöhen, die GPU-Auslastung zu verbessern und gemeinsam genutzte KI-Infrastrukturen effizienter und wirksamer zu betreiben", erklärte Nvidia.
Bereitgestellt werden die vollständige Run:ai-Plattform sowie einzelne Komponenten: KAI Scheduler, GPU Fractioning Operator, KAI Resource Management und Workload Map. Partner und Kunden können laut Nvidia entscheiden, ob sie die gesamte Plattform einsetzen, darauf eigene Produkte aufbauen oder einzelne Komponenten integrieren.
Neben Run:ai hat das Unternehmen nach eigenen Angaben Softwarekomponenten für die "Konfiguration von Netzwerken, Validierung von Clustern, Verwaltung von Racks und Bereitstellung von Bare Metal" als Open Source veröffentlicht.
Die ursprünglich für DGX Cloud entwickelten Komponenten umfassen Nvidia Config Manager, Nvidia Cluster Readiness Engine, Nvidia Rack Management Service und Cluster API Provider for Nvidia Infrastructure Controller.
Mit diesen Softwarekomponenten können Cloud-Anbieter und Softwarepartner laut Nvidia "Funktionen einer KI-Fabrik direkt in ihre mandantenfähigen Plattformen integrieren".
Nvidia bringt Vera-Rubin-MGX-Rack-Design in das OCP ein
Nvidia hat die dritte Generation seines Referenzdesigns MGX für KI-Rechenzentren in das OCP eingebracht. Damit sollen Hersteller interoperable Plattformen rund um die Server-Racks Vera Rubin NVL72 und Vera CPU des KI-Infrastrukturanbieters entwickeln können.
"In Kombination mit offenen Flüssigkeitskühlungstechnologien wie MQD und MQDB trägt die Initiative dazu bei, bewährte Designs für KI-Fabriken in Industriestandards zu überführen, die andere übernehmen, fertigen und skalieren können", erklärte das Unternehmen.
Die Spezifikation MGX 1.2 bietet laut Nvidia "Blind-Mate-Flüssigkeitskühlung auf Rack-Ebene, eine interoperable Verbindungsinfrastruktur auf Rack-Ebene und eine flüssigkeitsgekühlte 5.000-Ampere-Stromschiene für KI-Systeme mit höherer Leistungsaufnahme".
Nach Angaben des Anbieters erweitert die Spezifikation außerdem die Modularität von MGX durch "konfigurierbare I/O-Schächte, lüfterlose flüssigkeitsgekühlte Recheneinschübe sowie standardisierte Strom- und Kühlschnittstellen".
Sie verbessere Montage-, Test- und Wartungszeiten, vereinfache Fertigung und Vor-Ort-Service und ermögliche dadurch einen "schnelleren und effizienteren Infrastrukturausbau", schrieb der KI-Infrastrukturanbieter. "Die Architektur unterstützt Rack-Bereitstellungen mit bis zu 250 kW und vereinfacht zugleich Wartbarkeit, Bereitstellung und Wiederverwendung der Infrastruktur."
Der Artikel erschien zuerst bei unserer Schwesterpublikation crn.com.
CRN-Newsletter beziehen und Archiv nutzen - kostenlos: Jetzt bei der CRN Community anmelden